Main Modules
基本配置
先导入常用的包
然后我们设置好训练的
batch 以及学习率以及训练次数GPU硬件的选择参考上一节中的内容
数据的读入
终于看完了枯燥的铺垫😄
PyTorch以dataset+dataloader的形式读入数据,官网对此的描述如下
PyTorch provides two data primitives:torch.utils.data.DataLoaderandtorch.utils.data.Datasetthat allow you to use pre-loaded datasets as well as your own data.Datasetstores the samples and their corresponding labels, andDataLoaderwraps an iterable around theDatasetto enable easy access to the samples
我们可以得知,Dataloader负责的是数据的包装与使用,Dataset是储存数据的结构。我们可以定义自己的Dataset类来实现灵活的数据读取,定义的类需要继承PyTorch自身的Dataset类
我们先看看怎么下载网上(Standard datasets)现有的数据集(FasionMNIST为例)
我们还可以自己在本地造数据集,类似这样

然后直接通过
datasets.ImageFolder() 转换成数据集就可以了这里有一个很confusing的地方,那就是因为python本身是从0开始索引,也就是
new_dataset 应该从0开始,但是figure.add_subplot(rows, cols, i+1) 必须从1位置开始添加最后效果如下

怎么自己手动定义数据集呢,我们要采用三个函数
__init__: 用于向类中传入外部参数,同时定义样本集
__getitem__: 用于逐个读取样本集合中的元素,可以进行一定的变换,并将返回训练/验证所需的数据
__len__: 用于返回数据集的样本数
其实是很好实现的,可以自己写也可以照搬官方文档(下面的就是文档例子)
关于
__getitem__的一点说明- 使用
self.img_labels.iloc[idx, 0]获取第idx行、第 0 列的图像文件名,再用os.path.join(self.img_dir, filename)构建完整的图像文件路径
- 使用
self.img_labels.iloc[idx, 1]获取第idx行、第 1 列的标签
- 如果指定了
transform,则将图像应用该转换操作
- 如果指定了
target_transform,则将标签应用该转换操作
Build Your Model
Build a neural network
我们先理解神经网络的构造。神经网络,顾名思义,是要对人脑进行模拟(如果你学过生物你就自然明白了)

输出层输入层很好理解,不好理解的是隐藏层,简单来说,隐藏层背负了 特征提取 的伟大使命,隐藏层每一个节点会对输入层的兴奋有不同的接收权重,从而更加偏向于某种识别模式
我们现在来看一个简单的例子
Module 类是 torch.nn 模块里提供的一个模型构造类,是所有神经网络模块的基类,我们通过继承它来定义我们想要的模型。我们看一个简单的例子,这个例子意图实现手写数字的识别我们给出如下解释:
self.fc1 = nn.Linear(input_size, hidden_size)::这行代码创建了一个全连接层 (nn.Linear),并将它赋值给了self.fc1。全连接层将输入特征的维度input_size映射到隐藏层的大小hidden_size
什么是全连接层
就是一个层,他接受了来自上一层的所有输入信号,并在整合处理后负责输出
self.relu = nn.ReLU()::这行代码创建了一个 ReLU 激活函数 (nn.ReLU) 的实例,并将其赋值给了self.relu
ReLU 是一种常用的非线性激活函数,用于增加模型的非线性能力。简单来说,激活函数,并不是去激活什么,而是指如何把“激活的神经元的特征”通过函数把特征保留并映射出来,即负责将神经元的输入映射到输出端。事实上,ReLU函数就是
self.fc2 = nn.Linear(hidden_size, num_classes)::这行代码创建了另一个全连接层,并将其赋值给了self.fc2。这个全连接层将隐藏层的输出映射到分类数num_classes。
def forward(self, x)::这是一个用于定义前向传播过程的方法,它接受输入x并返回模型的输出。在 PyTorch 中,我们需要自己定义模型的前向传播过程,以确定数据如何通过网络流动。
out = self.fc1(x)、out = self.relu(out)和out = self.fc2(out):这些行代码描述了数据在网络中的流动过程。首先,输入x通过第一个全连接层self.fc1,然后通过 ReLU 激活函数self.relu,最后通过第二个全连接层self.fc2
在上述的类
SimpleNN 中,我们不需要定义backward() 反向传播函数,系统将通过⾃动求梯度⽽自动⽣成反向传播所需的 backward 函数我们可以实例化
SimpleNN 类得到模型变量 net 。下⾯的代码初始化 net 并传入输⼊数据 X 做一次前向计算。其中, net(X) 会调用 SimpleNN 继承⾃自 Module 类的 __call__ 函数,这个函数将调⽤用 SimpleNN 类定义的forward 函数来完成前向计算。这里是一个用来识别手写数字的神经网络的代码
这个神经网络有个精度和准确度的问题,在我进行识别的时候,进行了一个对传入图片的变形(压成一维),导致在2和5的识别上有重大的问题😭,写太粗了分不出来
下面开始解释:
self.conv1 = nn.Conv2d(1, 32, 3, 1) 这是一个卷积层,什么是卷积层?!你还不知道什么是卷积层?!我只好告诉你了,我们先看看什么是数学上的卷积:好抽象啊😭,看不懂思密达。不要紧,看个例子就会了
我们假设小王是一个A股股民🥺,出于某些众所周知的原因,A股每天都稳步下降,我们设这个下降函数是,但是愚蠢的小王依然每天加仓,稳步买入,设第t天持仓增量为显然,如果从第1天开始考虑,到第T天,显然,小王的亏损应该是
是不是恍然大误了?所以在图像处理上这有什么妙用呢?
再来看看这样一张图片

图片在修复之前,全是噪点,在修复之后,显然感觉视觉上更顺眼了。噪点在数学上显然是undesirable的,因为这意味着突然的峰值,类似于你做实验的极端偏差值,极度不利于我们的拟合。所以,我们需要修复噪点!
按照我们前面说的,图片就可以理解成张量(矩阵),那我们只要给几个相邻的元素取一个均值不就可以了嘛。
就像这张图片一样,滑动的计算新的张量
放在整个图片上就是像这样
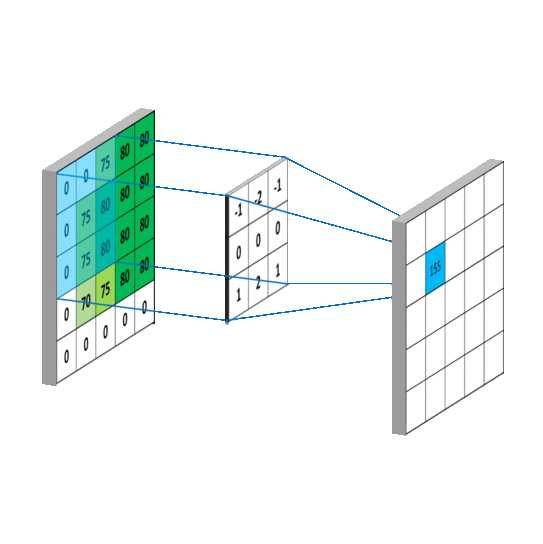
是不是又恍然大误了!于是你就明白我们的卷积层是干嘛的了。下面我们再来看看为什么卷积层的参数要这么设置。
self.conv1 = nn.Conv2d(1, 32, 3, 1) 我们来看看,第一个参数,是in_channel ,代表的是图片的输入通道数,在开始的时候(初始数据)1就意味着是黑白的,3就是彩色的;再看看32,这是
out_channels 也就是输出的通道数,也等价于我们 kernel 的数量,你问我什么是?赶紧多看看你的线性代数吧。3代表的是的宽高,而最后的1代表的是滑动的步幅。当然经过这一层后我们考察一下输出的大小,由于MINST的数据集都是28x28像素的照片,一个3x3的方格子在一个方向上显然可以滑动次,所以应该是单个得到的图像是26x26,所以总的输出是。
好的,现在我们来看看第二个层,池化层。你又要问了,什么是池化。好理解的,池化就是池化的作用就在降采样:保留显著特征、降低特征维度,减低计算难度。
在我们的代码中,我们有
nn.functional.max_pool2d(x, 2) ,意味着我们每4个像素取一次均值(事实上这里是最大值在代表)最后我们再来看看丢弃层
self.dropout1 = nn.Dropout2d(0.25),这又是什么意思呢?丢弃层是一种在训练神经网络时用来防止过拟合的技术。 在这个丢弃层中,0.25是丢弃率,表示在每次训练步骤中,有25%的神经元会被随机选择并暂时在前向传播和反向传播过程中被忽略。这样可以使模型更加健壮,因为它不会过度依赖任何一个神经元。 就是类似于上课随机开小差以增加听课的健壮性(bushi)然后,完结撒花,你就能看懂前面的代码啦🎉!